«Яндекс» благодарит чувашских партнеров
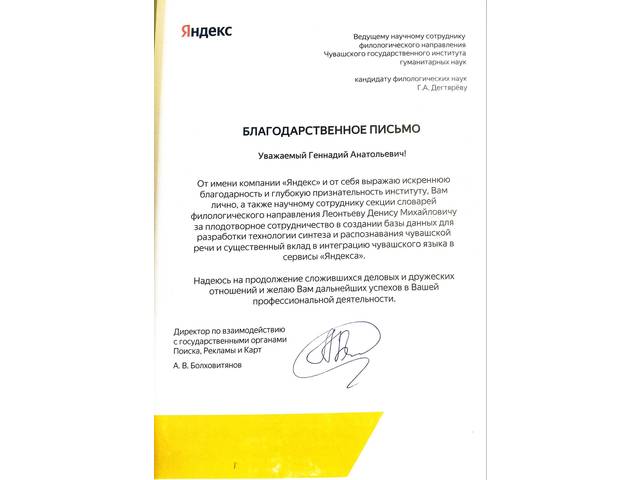
9 апреля 2025 г. компания «Яндекс» вручила сотрудникам Чувашского государственного института гуманитарных наук Геннадию Дегтярёву и Денису Леонтьеву благодарственные письма, отметив их вклад в интеграцию чувашского языка в сервисы «Яндекса» и создание базы данных для разработки технологии синтеза и распознавания чувашской речи.
Представители компании обратились в ЧГИГН 16 июля 2024 г. с просьбой помочь в подготовке аудиоматериалов, необходимых для обучения нейросетевых моделей распознавания речи, и в оценке качества синтезированной речи на чувашском языке. Такая работа намечалась в рамках проекта, направленного на развитие и поддержку чувашского языка в сервисе Яндекса «Переводчик», а также в системах распознавания и синтеза чувашской речи.
Приказом директора института Юрия Исаева ответственным за реализацию совместного с ООО «Яндекс» проекта был назначен ведущий научный сотрудник филологического направления Геннадий Дегтярёв.
Обучение нейросети распознавания речи требует не менее 100 часов аудиозаписей живой речи, в том числе фраз, фиксированных в разных акустических условиях. На первоначальном этапе была сформирована рабочая группа из более 30 человек от 18 до 70 лет, хорошо владеющих чувашским языком. Были установлены приложения в разных операционных системах для выполнения заданий. Создание общего чата в мессенджере способствовало координированию действий и оперативному выявлению и решению проблем при работе с приложениями.
Тестовая запись сначала осуществлялась по некорректированным текстам. Методом проб и ошибок были разработаны критерии записи и выборки текстов из баз данных. «Яндексу» был предоставлен анализ качества входных текстов. После внесенных правок была создана новая выборка текстов для начитки. Этап корректировки входных текстов длился приблизительно два месяца, после чего был выработан единый подход к выборке текстов для записи.
Проводились встречи с представителями «Яндекса» для определения продуктивности синтезатора речи. Формировались файлы оценки качества синтезированной чувашской речи. Составлялись алгоритмы для правил чувашского языка (акцентуация, произношение числительных, варианты называния календарных месяцев и т.д.).
Работа над проектом заняла около пяти месяцев и велась также вне установленного рабочего времени, в вечерние часы и в выходные дни, что говорит о большой заинтересованности участников в достижении результата. На всех этапах реализации проекта неоценимую помощь оказывал научный сотрудник института Денис Леонтьев.
Общими усилиями внедрение системы распознавания речи в целом завершено, а технология синтеза чувашской речи еще требует корректировки, и работа в этом направлении будет продолжена.
